Procesos en estado D en Linux: por qué kill -9 no funciona
Qué es el estado D en Linux, por qué kill -9 no mata esos procesos, cómo diagnosticarlos y cómo evitar que un almacenamiento de red caído bloquee tus backups.
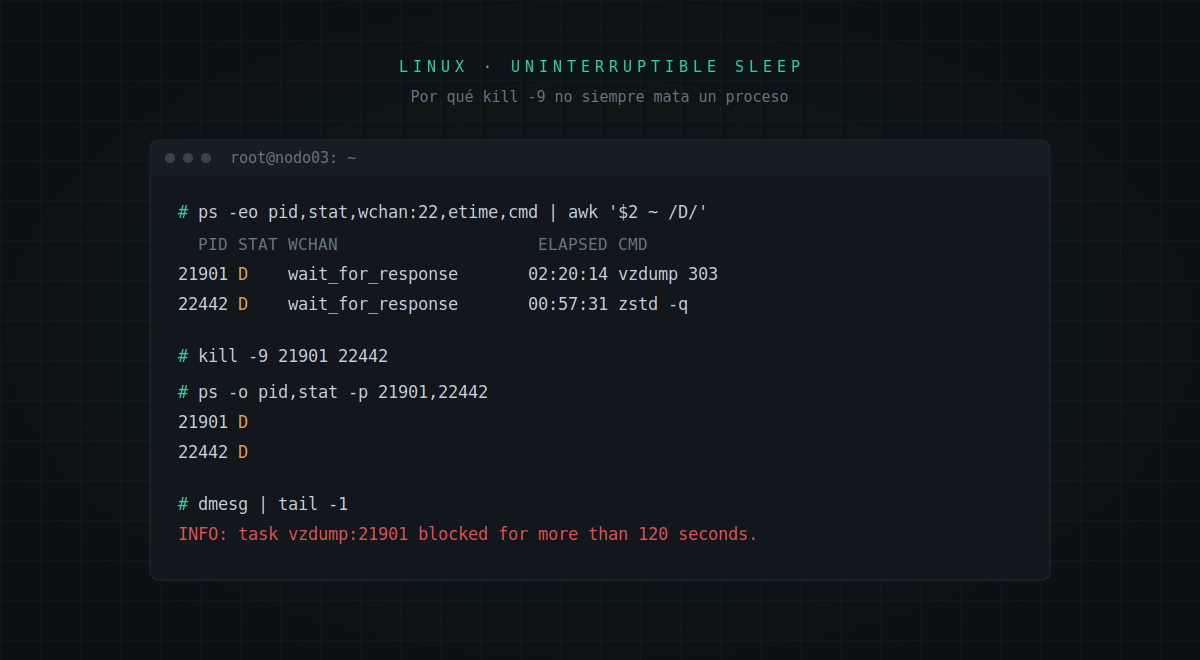
Hay pocas situaciones más frustrantes para un administrador de sistemas: un proceso colgado, ejecutas kill -9 y no pasa nada. Lo repites, intentas desmontar el recurso con umount -f, y el proceso sigue ahí, inmutable. Mientras tanto, la carga del servidor sube sin que la CPU esté haciendo nada.
Casi siempre, la causa es la misma: el proceso está en estado D (uninterruptible sleep). Un escenario típico es un backup que escribe en un recurso compartido de red (CIFS/SMB o NFS) cuando el servidor remoto deja de responder: los procesos del backup se quedan esperando una respuesta que nunca llega, y ni siquiera kill -9 puede sacarlos de ahí.
En este artículo verás qué es exactamente el estado D, por qué el kernel no permite terminar esos procesos, cómo diagnosticarlo y, sobre todo, cómo diseñar el almacenamiento para que no te vuelva a pasar.
Los estados de un proceso en Linux
Cada proceso en Linux tiene un estado, visible en la columna STAT de ps:
| Estado | Significado |
|---|---|
R |
En ejecución o listo para ejecutarse. |
S |
Dormido, esperando un evento. Se puede interrumpir con una señal. |
D |
Dormido sin posibilidad de interrupción, normalmente esperando una operación de E/S. |
Z |
Zombie: ya terminó, pero su proceso padre aún no ha recogido su estado. |
T |
Detenido, por ejemplo con Ctrl+Z o un depurador. |
La diferencia clave está entre S y D. Un proceso en S espera algo, pero si recibe una señal se despierta y la atiende. Un proceso en D está dentro de una operación del kernel que no puede abandonarse a medias, normalmente una lectura o escritura en disco o en red.
Por qué kill -9 no funciona
Las señales, incluida SIGKILL, no actúan en el momento en que se envían. El kernel las marca como pendientes y el proceso las atiende cuando vuelve a un punto seguro, normalmente al regresar de una llamada al sistema.
Un proceso en estado D está esperando dentro del kernel a que termine una operación de E/S, y esa espera no se interrumpe con señales. El motivo es proteger la integridad de los datos: abandonar a medias ciertas operaciones de disco o de sistema de archivos podría dejar estructuras internas en un estado inconsistente.
El resultado es que kill -9 sí llega: la señal queda pendiente y el proceso terminará en cuanto la operación finalice o falle. El problema es que, si el servidor remoto no responde, esa operación puede no terminar nunca.
Desde hace años, el kernel ofrece una variante de esta espera que sí atiende SIGKILL, y muchos sistemas de archivos de red la usan en buena parte de sus operaciones. Pero no en todas, y en la práctica sigue siendo común encontrarse procesos bloqueados que no terminan.
Síntomas típicos
- Procesos que no responden a
kill -9. - Carga del sistema (load average) alta con la CPU casi sin uso. En Linux, el load average cuenta también los procesos en estado D, así que decenas de procesos esperando a un almacenamiento caído disparan la carga sin consumir CPU. Es una de las pistas más claras.
- Comandos como
lsodfque se quedan colgados al acceder al punto de montaje afectado. El propio comando entra también en estado D. - Mensajes en
dmesgcomo:
INFO: task vzdump:21901 blocked for more than 120 seconds.
Ese aviso lo genera el detector de tareas bloqueadas del kernel (hung task detector), que por defecto avisa cuando un proceso lleva más de 120 segundos en estado D.
Cómo diagnosticarlo
1. Localizar los procesos en estado D
ps -eo pid,stat,wchan:32,etime,cmd | awk 'NR==1 || $2 ~ /D/'La columna wchan indica en qué función del kernel está esperando el proceso, y etime, cuánto tiempo lleva así. Si aparecen funciones relacionadas con CIFS, NFS o respuestas de red, ya tienes una pista clara.
2. Ver la pila del kernel del proceso
cat /proc/<PID>/stackMuestra la cadena completa de funciones del kernel donde está bloqueado. Si aparecen módulos como cifs o nfs, el problema está en el almacenamiento de red.
3. Volcar todas las tareas bloqueadas
echo w > /proc/sysrq-trigger
dmesg | tail -100
Hace que el kernel escriba en el log el estado de todas las tareas en espera no interrumpible, con sus pilas. Es muy útil cuando hay muchos procesos afectados.
4. Comprobar el almacenamiento remoto
Que el servidor responda al ping no significa que el servicio funcione. Comprueba el puerto (445 para SMB, 2049 para NFS) y, sobre todo, si el protocolo responde:
nc -zv 10.0.0.50 445
smbclient -L //10.0.0.50 -U usuario
Un caso común es que la red y el puerto respondan, pero el servicio SMB del servidor esté bloqueado: la conexión TCP se establece, pero la negociación del protocolo nunca termina.
Cómo resolverlo
Opción 1: recuperar el almacenamiento remoto
Es la solución más limpia. Si el servidor de archivos vuelve a responder, o si el cliente logra dar la conexión por perdida, las operaciones pendientes terminan (con éxito o con error) y los procesos por fin atienden la señal y terminan. Muchas veces basta con reiniciar el servicio SMB o NFS del servidor remoto, o cerrar sus sesiones bloqueadas.
Opción 2: desmontar el recurso
umount -f /mnt/recurso    # fuerza el desmontaje de un sistema de archivos de red
umount -l /mnt/recurso    # desmontaje "perezoso": lo retira del árbol de directorios
umount -f puede abortar las peticiones pendientes en algunos sistemas de archivos de red, pero no siempre libera a los procesos. umount -l solo oculta el montaje: los procesos que ya estaban bloqueados siguen esperando.
En Proxmox hay un detalle adicional: el servicio de estado vuelve a montar automáticamente los almacenamientos definidos. Si estás investigando, desactiva temporalmente el almacenamiento para que no se vuelva a montar:
pvesm set <nombre-almacenamiento> --disable 1Opción 3: reiniciar el servidor
Si el almacenamiento remoto no se puede recuperar, el reinicio suele ser la única forma confiable de eliminar procesos en estado D. Antes de hacerlo:
- Migra o apaga de forma ordenada las máquinas virtuales o servicios del servidor.
- Ten en cuenta que el apagado puede quedarse colgado al intentar desmontar el recurso bloqueado. Ten a mano el acceso por consola (iDRAC, iLO, IPMI) por si hay que forzarlo.
Cómo evitar que vuelva a pasar
Aquí está el verdadero valor: diseñar el almacenamiento de backups para que una falla remota no deje colgado al servidor.
- Usa un destino de backup diseñado para eso. En entornos Proxmox, Proxmox Backup Server es mucho más robusto que un recurso CIFS genérico: ofrece deduplicación, verificación de copias y un protocolo propio pensado para este uso.
- No hagas depender los backups de un servidor frágil. Un recurso compartido en un NAS doméstico o en una máquina virtual que corre en el mismo clúster que respalda es una mala idea: si falla el clúster, falla el destino.
- Revisa las opciones de montaje. En NFS, un montaje
softevita bloqueos indefinidos, pero puede provocar corrupción silenciosa en escrituras; para datos importantes suele preferirsehardcombinado con un buen monitoreo. En CIFS, revisa las opciones de tiempo de espera y reconexión que ofrece tu versión. - Monitorea el destino de backup, no solo el trabajo. Una alerta sobre la disponibilidad del servicio SMB o NFS te avisa antes de que el backup nocturno se cuelgue.
- Vigila las tareas bloqueadas. Generar alertas con los mensajes
blocked for more than 120 secondsde los logs, o con un load average alto y CPU baja, permite detectar el problema a primera hora y no cuando alguien se queja. - Programa los backups en horarios escalonados. Lanzar todos los trabajos a la vez contra el mismo destino aumenta la probabilidad de saturarlo.
Preguntas frecuentes
¿Un proceso en estado D consume CPU? No. Está dormido esperando E/S. Pero sí cuenta en el load average; por eso la carga sube aunque la CPU esté libre.
¿Es lo mismo un proceso zombie que uno en estado D? No. Un zombie ya terminó y solo ocupa una entrada en la tabla de procesos hasta que su padre recoge su estado. Un proceso en estado D sigue vivo, bloqueado dentro del kernel.
¿Por qué no se puede forzar el fin de un proceso en estado D? Porque está en medio de una operación del kernel que, si se interrumpiera, podría dejar datos o estructuras en un estado inconsistente. El kernel prioriza la integridad frente a la posibilidad de terminar el proceso.
¿Cómo sé qué almacenamiento está causando el bloqueo?
Con cat /proc/<PID>/stack o echo w > /proc/sysrq-trigger: la pila del kernel indica el módulo implicado (por ejemplo cifs o nfs), y lsof -p <PID> o ls -l /proc/<PID>/fd muestra qué archivos tiene abiertos.
Conclusión
Un proceso que ignora kill -9 no es una falla de Linux: es el kernel protegiendo la integridad de una operación de E/S que no puede abandonar a medias. Entenderlo cambia la forma de abordar el problema: en lugar de insistir con señales, hay que mirar hacia el almacenamiento que no responde. Y, sobre todo, hay que diseñar los backups para que la caída de un destino remoto sea una alerta en el monitoreo y no un servidor bloqueado a primera hora de la mañana.